Як об’єднати 500+ LLM в один пайплайн без хаосу в коді
LLM-роутер - це єдиний шар коду, через який усі агенти викликають моделі. Агент знає лише свою задачу, а вибір моделі, fallback і ліміти витрат живуть у конфігу. Робоча зв’язка для SMB: LangGraph (оркестрація) + власний роутер із YAML (бізнес-правила) + OpenRouter (доступ до сотень моделей через один API).
Я будую AI-агентів, Telegram-ботів, CRM-інтеграції та мультиагентні системи для малого й середнього бізнесу. Рано чи пізно в кожному такому проєкті виникає те саме: агентів стає багато, моделей ще більше, а перевіряти й міняти їх вручну вже неможливо.
Нижче - архітектура, яка це лікує: роутинг, fallback, контроль витрат і зрозумілий код. Те, що реально працює.
Яка проблема: 500 моделей - це ризик, а не перевага
Доступні моделі OpenAI, Anthropic, Google, Meta, DeepSeek, Qwen, Mistral та десятків інших провайдерів. Якщо кожну підключати окремо, виходить хаос:
різні API, формати відповідей і ліміти;
різні ціни за токени;
модель неможливо швидко замінити, якщо провайдер упав або підняв ціну;
незрозуміло, який агент яку модель і навіщо викликав;
кожна зміна моделі ламає частину бізнес-логіки.
Завдання не в тому, щоб ''використати 500 моделей''. Завдання - створити один керований шар виклику моделей і будувати агентів поверх нього.
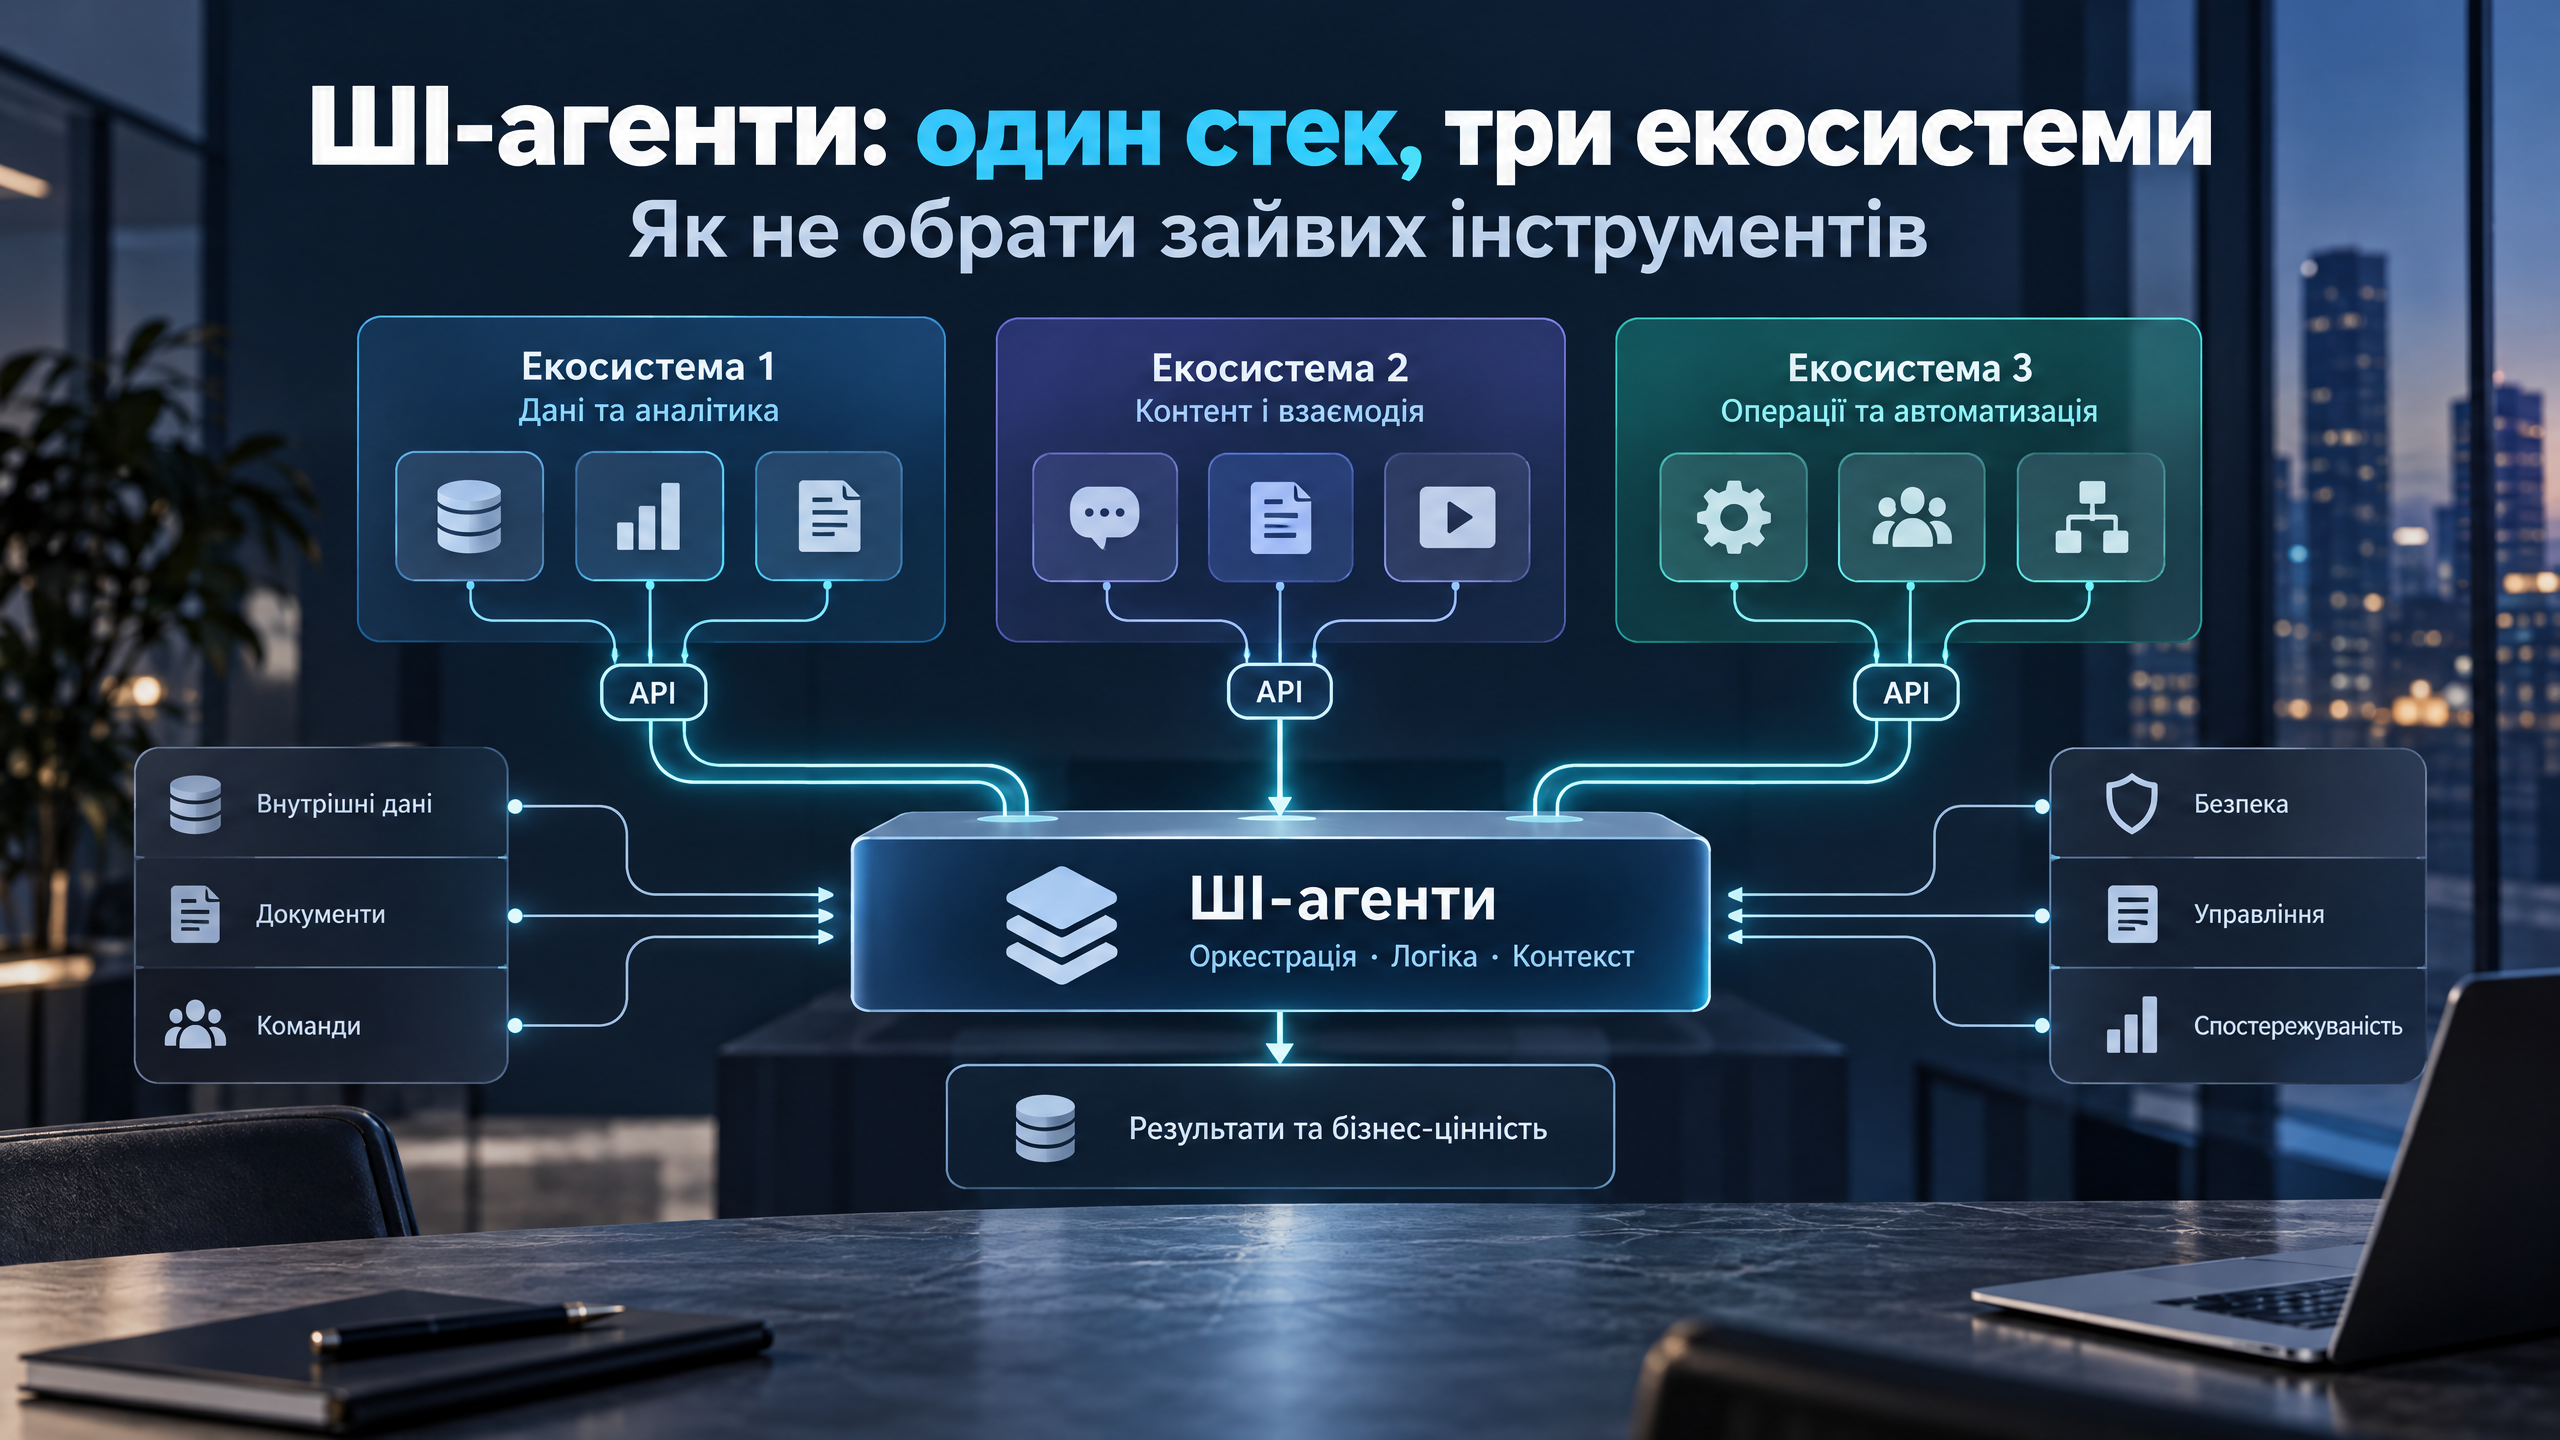
Яка архітектура працює: три шари
Бізнес-задача
     ↓
Telegram / CRM / Web App
     ↓
LangGraph: оркестрація агентів
     ↓
Власний Model Router (YAML)
     ↓
OpenRouter / Together AI / Groq / OpenAI / Anthropic / Google
1. Шар бізнес-логіки.
Конкретні сценарії: бот приймає заявку, агент класифікує запит, інший шукає дані в CRM, третій формує відповідь, четвертий перевіряє правила. Цей шар не знає, яка модель виконує роботу.
2. Шар оркестрації.
Тут визначено порядок дій: хто аналізує, хто виконує, хто перевіряє, коли потрібна людина. Для цього я використовую LangGraph: він поєднує детерміновані кроки з LLM-кроками в одному графі.
3. Шар моделей.
Єдине місце, де відбувається виклик LLM.
Чи потрібен OpenRouter, щоб об’єднати моделі?
OpenRouter - найпростіший спосіб отримати сотні моделей через один OpenAI-сумісний endpoint. Він підтримує fallback між моделями та сортування провайдерів за ціною, затримкою або пропускною здатністю (документація).
Приклад: один запит, кілька моделей.
import os
import requests

response = requests.post(
    "https://openrouter.ai/api/v1/chat/completions",
    headers={
        "Authorization": f"Bearer {os.environ['OPENROUTER_API_KEY']}",
        "Content-Type": "application/json",
    },
    json={
        "models": [
            "anthropic/claude-sonnet-4.5",
            "openai/gpt-5-mini",
            "google/gemini-3-flash-preview",
        ],
        "messages": [
            {"role": "user", "content": "Проаналізуй запит клієнта і запропонуй рішення."}
        ],
        "provider": {"sort": {"by": "price", "partition": "none"}},
    },
    timeout=60,
)
print(response.json())
Важливі нюанси, які легко пропустити:
За замовчуванням OpenRouter балансує навантаження між провайдерами. Але якщо задати
sort, балансування вимикається.partition: "none"сортує endpoint-и по всіх моделях разом. Тоді моделі зі списку перестають бути послідовними fallback-ами: система вибере найдешевший варіант серед усіх, а не першу модель. Якщо потрібен порядок «спочатку Claude, потім GPT», використовуйтеpartition: "model"(це значення за замовчуванням).Назви моделей у прикладах актуальні на жовтень 2026. Вони змінюються щомісяця, тому свіжі slug-и дивіться на openrouter.ai/models.
Це вже краще, ніж жорстко прописувати gpt-4o у десятках файлів.
Коли потрібен власний роутер?
OpenRouter вирішує проблему доступу до моделей. Але в бізнес-автоматизації потрібна логіка рівня бізнес-політик:
Простий запит → дешева швидка модель
Запит про гроші / договори → сильна модель
Потрібен пошук → модель із web search
Ризикова відповідь → верифікатор
Низька впевненість → передати людині
Тому я роблю власний router із YAML-конфігом.
Конфіг models.yaml
routes:
  faq:
    models:
      - openai/gpt-oss-20b
      - openai/gpt-5-mini
  sales:
    models:
      - anthropic/claude-sonnet-4.5
      - openai/gpt-5-mini
  code:
    models:
      - anthropic/claude-sonnet-4.5
      - openai/gpt-5-mini
    require_tools: true
  risky:
    require_human_review: true

fallback:
  model: google/gemini-3-flash-preview
  max_attempts: 2
Тепер зміна моделі - це зміна конфігу, а не переписування агентів.
Мінімальний роутер на Python
import os
import yaml
from openai import OpenAI

client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key=os.environ["OPENROUTER_API_KEY"],
)

with open("models.yaml", "r", encoding="utf-8") as f:
    config = yaml.safe_load(f)


def call_llm(model: str, prompt: str) -> str:
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    return r.choices[0].message.content


def choose_route(task_type: str) -> dict:
    return config["routes"].get(task_type, config["routes"]["faq"])


def run_task(task_type: str, prompt: str) -> dict:
    route = choose_route(task_type)

    if route.get("require_human_review"):
        return {"status": "needs_human_review", "prompt": prompt}

    max_attempts = config["fallback"]["max_attempts"]
    candidates = route["models"][:max_attempts] + [config["fallback"]["model"]]

    for model in candidates:
        try:
            return {"status": "ok", "model": model, "answer": call_llm(model, prompt)}
        except Exception as e:
            print(f"Model failed: {model} — {e}")

    return {"status": "error"}
Це спрощений приклад: у продакшені додайте логування кожного виклику, таймаути та обмеження вартості.
Як LangGraph не дає агентам перетворитись на спагеті?
LangGraph - це runtime для станних агентів: вузли - це кроки, ребра - логіка переходів. Він підтримує збереження стану, streaming і human-in-the-loop.
START → Classifier → Worker → Verifier → END
                                  ↓
                            Human Review
from typing import TypedDict
from langgraph.graph import StateGraph, START, END


class State(TypedDict, total=False):
    question: str
    task_type: str
    result: dict
    approved: bool


def classify(state: State) -> dict:
    # У продакшені тут дешева швидка модель; для прикладу — заглушка
    return {"task_type": "faq"}


def worker(state: State) -> dict:
    return {"result": run_task(state["task_type"], state["question"])}


def verifier(state: State) -> dict:
    # Тут перевіряємо факти, тон і правила; для прикладу — заглушка
    return {"approved": state["result"].get("status") == "ok"}


def human_review(state: State) -> dict:
    return {}


graph = StateGraph(State)
graph.add_node("classify", classify)
graph.add_node("worker", worker)
graph.add_node("verifier", verifier)
graph.add_node("human_review", human_review)

graph.add_edge(START, "classify")
graph.add_edge("classify", "worker")
graph.add_edge("worker", "verifier")
graph.add_conditional_edges(
    "verifier",
    lambda s: "end" if s["approved"] else "review",
    {"end": END, "review": "human_review"},
)
graph.add_edge("human_review", END)

app = graph.compile()

result = app.invoke({"question": "Скільки коштує впровадження Telegram-бота?"})
Не все має вирішувати модель, особливо якщо йдеться про гроші, персональні дані чи юридичні ризики. Саме тому поруч із LLM-кроками стоять детерміновані.
Який провайдер для чого?
| Сервіс | Найкраще застосування | Коли обирати |
|---|---|---|
| OpenRouter | Роутинг, fallback, швидка зміна моделей | Потрібен один API до сотень моделей |
| Together AI | Open-weight моделі, batch, fine-tuning | Дешева інференція або кастомна модель |
| Groq | Real-time боти, класифікація | Користувач чекає секунди, а не хвилини. Це інференс-хмара, не власна модель |
| OpenAI | Складний reasoning, tool calling | Потрібна передбачуваність екосистеми |
| Anthropic | Код, аналіз довгих документів | Глибока робота зі складним контекстом |
| Google Gemini | Мультимодальність, Workspace | Бізнес уже живе в Google-екосистемі |
| Sakana Fugu | «Мультиагентна система як одна модель» | Потрібна чорна скринька замість власної архітектури |
Орієнтири цін за 1M токенів (input / output) на жовтень 2026: Claude Sonnet 4.5 — $3 / $15, Gemini 3 Flash Preview — $0,50 / $3, Groq GPT-OSS 20B — $0,075 / $0,30. Ціни змінюються, тому перед розрахунками звіряйте їх із OpenRouter та groq.com/pricing.
Про Sakana Fugu.
Fugu - це мультиагентна система, яка поводиться як одна модель: ви надсилаєте запит на один model ID, а вона сама обирає й координує моделі. Для швидкого старту це цікаво, але є нюанс: станом на запуск сервіс був недоступний в ЄС і ЄЕЗ. Для SMB-автоматизацій я частіше обираю власний роутер, бо він прозорий і дає вставити бізнес-правила саме там, де вони потрібні.
Як виглядає архітектура Telegram-бота?
Telegram-бот → aiogram handler → LangGraph workflow
     ↓
Classifier Agent
     ↓
Model Router
     ├── FAQ → дешева швидка модель
     ├── Продажі → Claude / GPT
     ├── CRM-запит → tool calling
     └── Ризик → Human Review
     ↓
Verifier Agent → відповідь у Telegram
Classifier не повинен бути дорогим: достатньо малої швидкої моделі.
Worker обирається за типом задачі.
Verifier перевіряє фактологію, тон і порушення правил.
Human review вмикається лише для ризикових кейсів.
Усі виклики моделей проходять через один роутер.
Так ви отримуєте не ''500 моделей у коді'', а 500 моделей за одним інтерфейсом.
Реальний результат
[ВСТАВТЕ СВОЇ ДАНІ] - один конкретний кейс із цифрами: скільки витрат було до та після, яка latency, скільки викликів на добу, який тип задач. Один виміряний кейс робить статтю значно сильнішою за огляд і дає AI-відповідям що цитувати.
Як зекономити на токенах?
Не використовуйте флагман для всього. Класифікація, витяг полів, коротка відповідь і модерація - для дешевих моделей. Флагман - для складного аналізу, коду й багатокрокового reasoning.
Кешуйте повторювані запити. FAQ, системні промпти, довідники.
Обмежуйте контекст. Останніх 10 повідомлень і стисненого профілю клієнта зазвичай достатньо.
Логуйте кожен виклик: агент, модель, токени, вартість, latency, статус (success / fallback / error), task_type. Без цього оптимізувати нічого.
Обмежуйте fallback. Без лімітів він непомітно збільшує витрати або погіршує якість:
fallback:
  max_attempts: 2
Які типові помилки?
Агент знає назву моделі. Погано: model = "gpt-4o". Краще: model = router.get_model("sales").
Усі агенти мають однаковий промпт. У кожного має бути власна роль, обмеження, формат відповіді та критерії успіху.
Немає верифікатора. Якщо агент формує ціну, юридичну відповідь або повідомлення клієнту, результат має хтось перевіряти.
Немає human-in-the-loop. Не кожна дія має виконуватись автоматично, особливо коли вона впливає на гроші, CRM, рекламні бюджети чи комунікацію з клієнтом.
Немає observability. LangSmith, власні логи або проста таблиця в Postgres уже покажуть, де система витрачає гроші й де ламається.
Який стек я рекомендую для SMB?
Python + aiogram + LangGraph + OpenRouter
+ PostgreSQL / Redis + LangSmith
+ Render / Cloudflare Workers
Це дає швидкий старт, незалежність від одного провайдера, контроль витрат, можливість додавати моделі без переписування логіки та нормальну діагностику.
FAQ
Що таке LLM-роутер?
Це шар коду, який приймає тип задачі та обирає модель за правилами з конфігу: ціна, якість, затримка, ризик. Агенти викликають роутер, а не конкретну модель.
Чи потрібен OpenRouter, якщо є власний роутер?
Не обов’язково, але він скорочує роботу: один ключ і один API замість окремих інтеграцій із кожним провайдером. Власний роутер додає бізнес-логіку поверх нього.
Чи потрібен LangGraph для простого бота?
Для одного кроку ''питання - відповідь'' ні. Він окупається, коли з’являються кілька агентів, перевірка результату та передача людині.
Як зробити fallback без росту витрат?
Обмежте кількість спроб (max_attempts) і вказуйте fallback-модель із цінового класу не вищого, ніж основна.
Скільки моделей реально потрібно?
У більшості SMB-проєктів 3–5: дешева швидка для класифікації, середня для основної роботи, сильна для ризикових задач, плюс резервна.
Висновок
P.S. Не будуйте систему навколо конкретної моделі. Будуйте її навколо задачі бізнесу. Моделі, ціни й навіть доступність провайдерів змінюються постійно: наприклад, Groq у серпні 2026 вимкнув llama-3.1-8b-instant, а це саме та модель, яку ще нещодавно радили всі, включно зі мною. Якщо маєте LangGraph для оркестрації, власний роутер для бізнес-правил, OpenRouter для мультипровайдерного доступу та verifier із human review для ризикових сценаріїв, то 500 моделей перестають бути хаосом і стають ресурсом.
Головне правило: агент не повинен знати, якою моделлю він працює. Він повинен знати лише свою задачу.
Що ще почитати в блозі: AI-агент замість форми заявки: LangChain + GoHighLevel і GoHighLevel 2026: усе в одному.
Джерела
About the author
- AI Consultant & Automation