Як платити за ШІ менше: оркестрація агентів і дешеві моделі
Коли агент працює над великою задачею, ліміт підписки часто закінчується раніше, ніж результат. Замість того щоб одразу переходити на дорожчий тариф, можна розділити роботу: сильна модель ухвалює рішення, дешева виконує рутину.
Коли працюєш з агентами, ліміти закінчуються раніше, ніж задача. Ти майже дійшов до результату, і тут лічильник упирається в стелю. Далі два варіанти: чекати, поки ліміти відновляться, або переходити на дорожчий тариф за 100, 200 чи 500 доларів на місяць.
Токени стали окремою статтею витрат. Тому їх варто рахувати так само, як будь-які інші витрати. У цьому тексті немає прогнозів. Є механіка: за що ми платимо, як розподіляти роботу між моделями, які прийоми реально зменшують витрату і де дешева модель підходить, а де ні.
Розділяйте задачу між сильною та дешевою моделлю.
Не змушуйте агента шукати файли — вказуйте шлях.
Вбудовуйте перевірку в перший промпт.
Для масової рутини використовуйте дешеві моделі через OpenRouter.
За що ми платимо
Є два способи платити за AI: підписка і API.
Підписка. Фіксована сума на місяць і ліміт використання в межах тарифу. API. Ви підключаєте модель до свого застосунку чи агента і платите за фактичну витрату: скільки тексту модель прочитала і скільки написала.
Обсяг рахують у токенах, тобто невеликих шматочках тексту. У токени входять ваш запит, уся історія розмови, вміст файлів, які агент відкрив, і відповідь моделі.
Що цікаво, ліміт підписки і ціна за API далеко не завжди збігаються. Компанія SemiAnalysis 5 жовтня 2026 року порівняла, скільки коштували б ті самі обсяги використання за API-тарифами і скільки за підписку (навантаження - агентна робота з великою часткою кешованих вхідних токенів).
Результати для середніх ''повсякденних'' моделей:
| Тариф | Claude (Opus 5.5) | ChatGPT (GPT-6.1 Sol) | Різниця |
|---|---|---|---|
| $20 | ≈ $1 178 | ≈ $211 | ≈ 5,6× |
| $100 | ≈ $5 725 | ≈ $1 055 | ≈ 5,4× |
| $200 | ≈ $11 726 | ≈ $2 084 | ≈ 5,6× |
P.S. Наведені числа - ілюстративна оцінка, а не офіційний прайс. Реальна вигода залежить від вашого обсягу, кешування та типу задач.
На топових моделях різниця менша: GPT-6 Astra на $200-плані дає близько $2 897 API-еквівалента (план вичерпується), Claude Fable 5.1 - близько $2 485 (і ще залишається половина ліміту, бо Fable обмежений 50 % квоти).
Важливе застереження: це порівняння лімітів, а не якості чи ціни окремої задачі. Воно не означає, що модель будь-яку задачу робить дешевше. Практичний висновок інший. Якщо ви працюєте з AI протягом дня і регулярно впираєтеся в ліміти, дорожчий тариф може бути вигіднішим, ніж доплачувати за додаткові запити через API. Рахуйте на своєму обсязі.
Два важелі економії
Вся економія зводиться до двох речей:
Як ми використовуємо моделі.
Які моделі ми використовуємо.
Спочатку про перший важіль, бо він працює з будь-якою моделлю.
Оркестрація: сильна модель думає, дешева виконує
Уявим задачу. Є вивантаження з 1000 коментарів під блогом, і з нього треба обрати три теми для наступних випусків. Тут дві різні роботи:
Продумати правила. Чим реальний запит на тему відрізняється від випадкової репліки? Які категорії потрібні? За якими ознаками обирати тему? Це робота для сильної моделі.
Пройти всі коментарі. Прочитати, поставити мітку, згрупувати схожі, записати в таблицю. Це повторювана рутина, і щоразу викликати найдорожчу модель для неї не обов’язково.
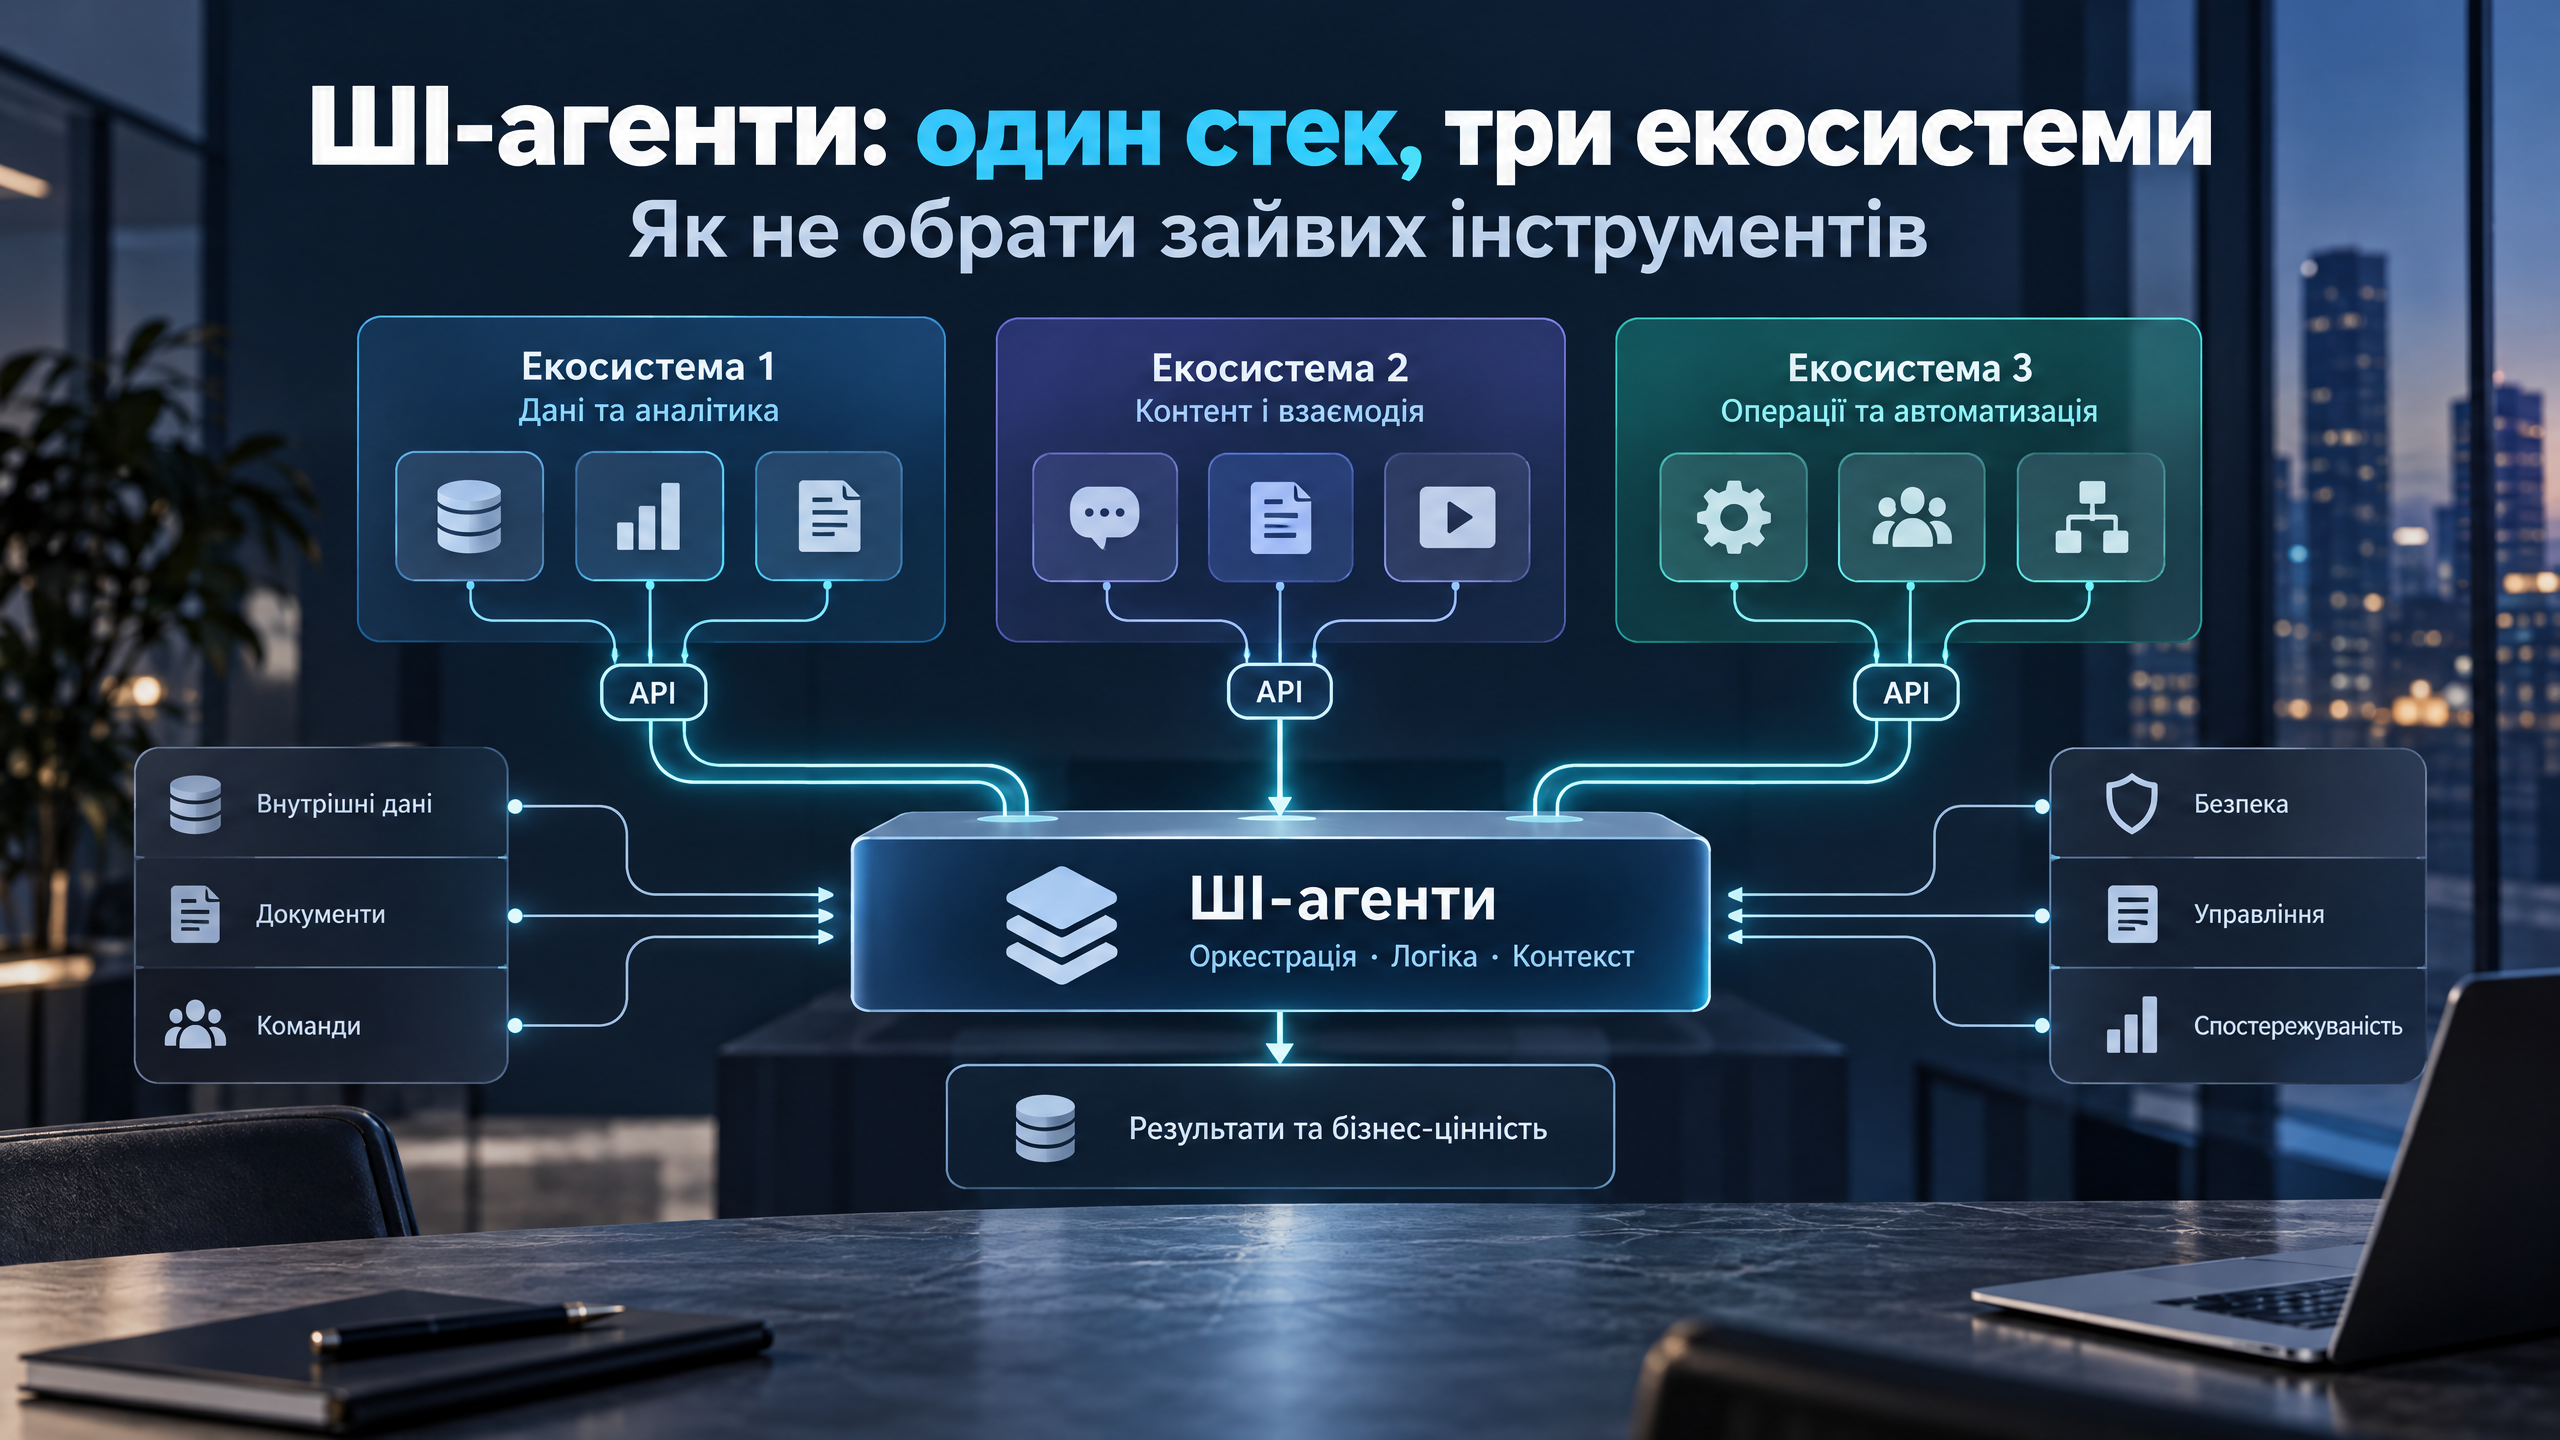
Тому задачу розділяємо. Сильна модель складає інструкцію. Дешевша розмічає дані. Потім сильна модель перевіряє спірні місця і допомагає обрати теми. Найоб’ємнішу частину, яка їсть більшість токенів, виконує дешева модель, а сильна підключається там, де потрібне міркування. Такий розподіл називається оркестрацією.
Можна уявити це як редактора і помічника. Редактор вирішує, що вважати хорошою темою. Помічник розкладає коментарі за його правилами. Редактор дивиться підсумок.
Як зібрати це в Codex
Нижче приклад у Codex. Те саме можна зробити і в Claude Code, принцип однаковий.
Підготуйте папку. Створіть окрему папку для проєкту, щоб агент працював тільки в ній. Покладіть туди таблицю, наприклад
comments.csv, з двома основними полями: номер коментаря і текст.Оберіть головного агента. Відкрийте Codex, додайте папку і створіть у ній чат. Внизу виберіть найсильнішу модель (у прикладі це GPT Astra). Вона буде оркестратором.
Опишіть систему промптом:
Підготуй у цій папці систему для регулярного розбору коментарів. У кореневому agents.md збережи загальні правила проєкту і окремо правила головного агента. Він пропонує категорії, передає розмітку помічнику, перевіряє результат і обирає теми. Сам усю таблицю не розмічає. Далі створи помічника з іменем comment-sorter. Вкажи ім’я, опис і інструкцію для цього помічника. Модель: GPT Luna, середнє зусилля міркувань. Помічник має розмічати коментарі за переданими категоріями, зберігати вихідні ID і позначати сумнівні випадки як needs_review. Поки не запускай обробку, покажи створені файли.
Після цього в папці з’являються:
agents.mdз правилами проєкту простою мовою: хто придумує категорії, хто розмічає, хто перевіряєокремі правила головного агента
файл помічника з іменем, описом, інструкцією і рядком з моделлю. За цим рядком Codex розуміє, на якій моделі запускати помічника.
4. Поставте задачу. Створіть новий чат у цій самій папці, знову оберіть Astra і напишіть:
За таблицею comments потрібно обрати три теми для майбутніх блогів. Проаналізуй таблицю і запропонуй три теми з прикладами коментарів, на яких оснований цей вибір.
Astra складає правила й оцінює результат, а Luna виконує довгу повторювану частину. Там і виникає економія.
Якщо задача одноразова, окремі файли не потрібні, вистачить одного промпту:
Ти оркестратор. Придумай категорії для коментарів з comments.csv. Розмітку доручи одному субагенту на моделі GPT Luna. Сам усю таблицю не розмічай.
Але коли ви будуєте систему з 4–10 агентів, окремі файли з явно прописаними моделями стають потрібними. В одному промпті все не врахуєш, а з файлами помилок менше і ви знаєте, яка модель що робить.
Чотири прийоми, які економлять токени на будь-якій моделі
1. Не змушуйте агента шукати
У запит потрапляє вся історія переписки, а якщо не вказати шлях до файлу, агент відкриває все підряд. Замість ''знайди коментарі до останнього блогу' пишіть:
Візьми файл comments.csv з папки «розбір коментарів» і запропонуй по ньому три теми для блогу.
Така сама проблема з довгими чатами. Якщо ви довго обговорювали категорії і пробували варіанти, перед наступним кроком попросіть:
Збережи в окремий файл коротку пам’ятку: що ми вирішили, де лежить готова таблиця і що залишилося зробити.
Потім відкрийте новий чат у цій папці і вкажіть файл з пам’яткою. Рішення переносяться, а довга історія проб і помилок лишається в старому чаті.
2. Закладайте перевірку в саму задачу
Інакше починається нескінченне «перевір», «виправ», «перевір ще раз». Кожен такий круг означає нову роботу моделі і нові токени. Замість 'перепровір' пишіть одразу:
Розбери коментарі за категоріями. Перед тим як надіслати результат, перевір, що нічого не пропущено і категорії присвоєно правильно, та виправ помилки.
3. Підбирайте глибину міркувань
Поруч із вибором моделі в Codex і Claude є налаштування глибини роздумів. Для складної задачі ставте більше, для рутини менше.
4. Просіть коротші відповіді
Менше вступів і 'води' дає менше вихідних токенів, а зрозуміліша відповідь рідше потребує перепитування. Один зі способів: попросити модель пояснювати за правилами ASD-STE100. Це стандарт спрощеної технічної англійської. Суть у коротких реченнях, одному абзаці на одну тему і однакових назвах для однакових речей. Приклад промпту, який можна додати до задачі або зберегти в agents.md:
Коли пояснюєш складні теми, пиши українською за принципами ASD-STE100. Один абзац присвячуй одній темі. Інструкції вкладай приблизно у 20 слів. Для однакових понять використовуй однакові слова. Не додавай вступів і підсумків, якщо я про них не просив.
Які моделі використовувати
Виконавцем не обов’язково має бути модель від OpenAI чи Anthropic. Вони дорогі, а з агентами витрата швидко зростає, і навіть з прийомами вище лімітів може не вистачати. Для частини задач варто дивитися на інші моделі, зокрема китайські: Kimi, DeepSeek, Qwen, GLM. У кожної є легкі версії для швидких і недорогих задач.
Для орієнтиру: станом на середину жовтня 2026 року Qwen3.8 Flash через OpenRouter коштує $0,15 за мільйон вхідних токенів і $0,47 за мільйон вихідних. Ціни швидко змінюються, тому перед використанням перевіряйте актуальні тарифи на openrouter.ai.
OpenRouter - сервіс, через який можна звертатися до моделей різних компаній. Один акаунт, один баланс, один API-ключ. Модель обираєте під задачу, не реєструючись окремо в кожного постачальника.
Спосіб 1. OpenRouter у звичному Codex або Claude
Зареєструйтеся на OpenRouter і відкрийте каталог моделей.
Оберіть модель. З недорогих платних: Qwen3.8 Flash, DeepSeek V3.2 / V4 Flash, Kimi K2.6 / K3. Є й безкоштовні варіанти (моделі з суфіксом
:free), їх можна пробувати без поповнення балансу, але з обмеженням на кількість запитів (зазвичай 20 запитів/хв і 50–1000 запитів/день). Вони підходять лише для дуже простих типових задач.Скопіюйте назву моделі для підключення.
У розділі Keys створіть API-ключ.
Для платної моделі поповніть баланс у Credits.
У Codex у папці з коментарями напишіть:
Підключи Kimi через OpenRouter для розмітки comments.csv. Модель: [вставити назву]. Ти придумуєш категорії і перевіряєш результат, а Kimi робить розмітку. Створи потрібний інструмент і підкажи, як безпечно підключити мій API-ключ OpenRouter.
API-ключ не вставляйте прямо в чат. Codex підкаже безпечніший спосіб, наприклад змінну середовища.
Далі попросіть для проби розібрати перші 20 коментарів. Якщо результат підходить, дайте команду:
Тепер оброби решту коментарів, перевір результат і запропонуй три теми для блогу.
У такій схемі працюють два лічильники. Головний агент витрачає ліміти підписки ChatGPT, а масові розмітки оплачуються з балансу OpenRouter за Kimi. Така розмітка 1000 коментарів часто коштує кілька центів - десятки центів. На великих обсягах різниця між схемами може бути відчутною, але рахуйте на своїх даних (див. нижче).
Спосіб 2. Orca
Orca (onorca.dev / stablyai/orca) - відкритий застосунок, який збирає кількох AI-агентів (Codex, Claude Code, Gemini та інших) в одному середовищі. Ви підключаєте свої акаунти, і один агент може керувати задачею, роздавати доручення іншим і збирати підсумок. Приклад розподілу ролей: сильна модель у Codex складає план і перевіряє, Kimi розбирає великі таблиці, Grok з пошуком збирає актуальну інформацію. Ролі ви обираєте самі, за ціною, якістю, швидкістю і тим, з чим модель краще справляється.
Корисна можливість: ви бачите витрату лімітів різних сервісів. Якщо в одній підписці ліміт майже вичерпано, а в іншій є запас, задачу можна передати туди.
Сам Orca безкоштовний, у підключених агентів лишаються їхні підписки і баланси. У мене немає партнерської угоди чи бонусів від Orca.
Які задачі дешева модель не вирішує
Для чесної картини варто назвати обмеження.
Якість. Дешева модель частіше помиляється, тому частину результатів перевіряйте вибірково. Для розмітки це 20–50 коментарів із різних категорій.
Вартість налаштування. Оркестрація, окремі файли агентів і ключі потребують часу. На одноразовій дрібній задачі це не окупиться.
Приватність. Безкоштовні моделі на OpenRouter можуть логувати запити або використовувати їх для навчання. Коментарі користувачів, клієнтські й комерційні дані туди не віддавайте. Перед підключенням прочитайте політику конкретного постачальника.
Як перевірити, що ви справді зекономили
Почніть із задачі, яку виконуєте регулярно, наприклад із розбору коментарів. Виконайте її звичним способом. Потім передайте основну роботу дешевшій моделі, де не потрібне глибоке міркування. Порівняйте результат і витрати.
Приклад орієнтовного заміру на 1000 коментарів (ілюстративний, на основі типових витрат жовтня 2026; зробіть свій):
| Показник | Одна сильна модель | Сильна + дешева (оркестрація) |
|---|---|---|
| Витрата токенів | ≈ 1,8–2,5 млн | ≈ 0,3–0,5 млн (сильна) + 1,2–1,8 млн (дешева) |
| Вартість / частка ліміту | $8–25 або значна частина денного ліміту | $0,4–2,5 (дешева частина) + невелика частка сильної |
| Час | 15–40 хв | 10–25 хв |
| Якість (помилки у вибірці 50 коментарів) | 2–5 % | 4–12 % (після вибіркової перевірки сильної моделі — близько до рівня сильної) |
Якщо результат такий самий корисний, а витрати менші, схему можна залишати. Зробіть власний замір на одній реальній задачі - це головний аргумент.
Що зробити вже сьогодні
Економія береться з двох місць: які моделі ви використовуєте і як ставите їм задачі. Складні рішення віддавайте сильній моделі, зрозумілу рутину пробуйте на дешевшій. Вказуйте агенту конкретні файли, заздалегідь описуйте бажаний результат і вбудовуйте перевірку в саму задачу. Не треба впроваджувати все одразу. Оберіть один прийом із цього тексту і спробуйте на своїй роботі.
На яких задачах у вас іде найбільше лімітів? Напишіть у коментарях або в Telegram-каналі @aibiz_ua, розберемо найцікавіші випадки.
Усі ключові цифри перевірені на 20 жовтня 2026. Ціни на OpenRouter і ліміти підписок можуть змінюватися
Джерела (станом на 20 жовтня 2026)
About the author
- AI Consultant & Automation